Translation Memory: Wie man damit Zeit und Geld spart
Stellen Sie sich folgende Situation vor: Ein großes Produktionsunternehmen bringt die jährliche Aktualisierung des Benutzerhandbuchs für eine komplexe Industrieanlage mit einem Umfang von dreihundert Seiten heraus. Die Änderungen betreffen lediglich einige wenige Baugruppen, und nicht mehr als fünf Prozent des Ausgangstextes wurden überarbeitet. Dennoch sendet ein unerfahrener Projektleiter das gesamte Dokument an eine Agentur und erhält eine Rechnung über die vollständigen Übersetzungskosten für alle dreihundert Seiten von Grund auf. Zwei-, drei- oder gar zehnmal für die Übersetzung derselben Sätze zu bezahlen, gehört zu den häufigsten und ärgerlichsten Fehlern im Unternehmensbereich. Solche unnötigen Ausgaben lassen sich durch die Translation-Memory-Technologie vermeiden, die die Wirtschaftlichkeit der internationalen Lokalisierung grundlegend verändert und transparente Kooperationsregeln zwischen Unternehmen und Dienstleistern geschaffen hat. In diesem Beitrag analysieren wir ausführlich, wie Translation Memorys aufgebaut sind, nach welchen Grundsätzen die tatsächliche Ersparnis für den Auftraggeber berechnet wird und warum diese Datenbank zum wichtigsten strategischen digitalen Vermögenswert jeder globalen Marke wird.
Was eine Translation-Memory-Datenbank ist und wie sie sich von neuronalen Netzen unterscheidet
Bei Auftraggebern von Sprachdienstleistungen kommt es nach wie vor häufig zu Verwechslungen zwischen dem Konzept des Translation Memory und Algorithmen der maschinellen Übersetzung. Hier muss der grundlegende Unterschied betont werden: Ein Translation Memory hat nichts mit künstlicher Intelligenz, generativen Netzwerken oder Wahrscheinlichkeitsberechnungen von Algorithmen zu tun. Es handelt sich um eine dynamische, kontinuierlich wachsende Datenbank, die ausschließlich aus Satzpaaren besteht, die zuvor von Menschen übersetzt und von qualifizierten Lektoren geprüft wurden.
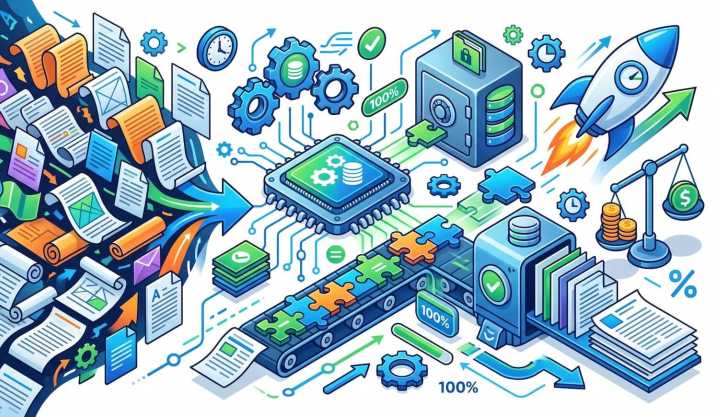
Jeder Eintrag in einer solchen Datenbank wird als Übersetzungseinheit oder Segment bezeichnet. Strukturell verbindet er den Ausgangssatz mit seiner exakten Entsprechung in der Zielsprache. Öffnet ein Sprachmittler eine neue Datei in einem spezialisierten Übersetzungsprogramm, analysiert das System augenblicklich den gesamten Text und gleicht jeden Satz mit der gesammelten Projekthistorie ab. War ein Satz bereits früher vorhanden, setzt das Programm unmittelbar die bestehende Version ein. Während maschinelle Übersetzung Texte auf der Basis statistischer Gesetzmäßigkeiten oder neuronaler Gewichtungen neu generiert, ruft das Translation Memory eine geprüfte, abgestimmte und vom Menschen freigegebene Lösung ab. Dadurch behält die professionelle Übersetzung ihre absolute Zuverlässigkeit und lückenlose inhaltliche Übereinstimmung.
Die Mechanik des Abgleichs: Von exakten Treffern bis zur unscharfen Suche
Die Stärke der Translation-Memory-Technologie liegt in einem mathematisch präzisen Klassifizierungssystem für Übereinstimmungen. Die Software unterteilt das gesamte analysierte Textvolumen in mehrere Kategorien, die den tatsächlichen Arbeitsaufwand des Übersetzers bestimmen.
Die erste Kategorie bilden hundertprozentige Treffer, bei denen der neue Satz buchstabengetreu einem Segment aus der Datenbank entspricht. Als noch verlässlicher gilt der Kontexttreffer, häufig als 101-Prozent-Treffer oder In-Context Exact Match bezeichnet. In diesem Fall stimmt nicht nur der Satz selbst überein, sondern auch der jeweils vorangehende und nachfolgende Satz, wodurch das Risiko eines Bedeutungsfehlers durch veränderten Kontext oder ein anderes Layout vollständig ausgeschlossen wird.
Die nächste Kategorie umfasst unscharfe Treffer, die sogenannten Fuzzy Matches. Das System ermittelt den Grad der Ähnlichkeit des neuen Satzes mit einem vorhandenen Segment in einer Spanne von fünfundsiebzig bis neunundneunzig Prozent. Hat sich in einer neuen Anleitung beispielsweise nur die Modellbezeichnung eines Geräts oder ein einzelner Parameterwert geändert, zeigt das Programm dem Übersetzer die alte Fassung an und hebt die anzupassende Stelle deutlich hervor. Schließlich werden interne Wiederholungen innerhalb desselben Dokuments separat erfasst. Wiederholt sich ein Slogan, eine Tabellenüberschrift oder ein Warnhinweis fünfzigmal im Handbuch, übersetzt der Sprachmittler diesen nur ein einziges Mal, und das System überträgt die Lösung automatisch auf die gesamte Datei.
Echte Budgeteinsparungen: Wie das Rabattraster funktioniert
Die klare Abstufung von Treffern hat zu einem branchenweit anerkannten Abrechnungsstandard geführt, der als CAT-Matrix oder Analyse-Raster bekannt ist. Vor Beginn der eigentlichen Arbeit scannt das Softwaresystem die bereitgestellten Dateien und erstellt einen detaillierten Bericht mit der genauen Wortverteilung nach Kategorien.
Auf der Grundlage dieses Berichts bezahlt der Auftraggeber das Projekt nicht nach einem einheitlichen Basistarif, sondern nach einer gestaffelten Skala. Für völlig neue Segmente ohne Entsprechung in der Datenbank wird der volle Preis berechnet. Für Fuzzy Matches mit hoher Ähnlichkeit zahlt der Kunde lediglich dreißig bis fünfzig Prozent des Basissatzes, da der Übersetzer nur wenige Zeichen anpassen muss. Für hundertprozentige Treffer, Kontexttreffer und interne Wiederholungen ist der Satz minimal oder es fällt gar kein Honorar an, sofern das Projekt kein erneutes Lektorat erfordert.
Bei umfangreichen Projekten zur Lokalisierung technischer Dokumentationen, juristischer Standardverträge oder Software-Benutzeroberflächen ermöglicht der Einsatz dieser Technologie dauerhafte Einsparungen von dreißig bis sechzig Prozent des Gesamtbudgets.
Terminologische Einheit und reibungslose Teamarbeit
Neben dem unmittelbaren finanziellen Vorteil löst das Translation Memory die zentrale Aufgabe der terminologischen Konsistenz. In großen Konzernen arbeiten oft Dutzende von Übersetzern aus verschiedenen Ländern gleichzeitig an der Lokalisierung eines Produkts. Cloud-basierte Plattformen wie Trados, memoQ, Smartcat oder Phrase ermöglichen es den Teams, sich in Echtzeit mit einer gemeinsamen, zentralen Datenbank zu verbinden.
Sobald ein Übersetzer eine anspruchsvolle Bauteilbezeichnung oder eine Menüfunktion übersetzt und freigibt, steht dieses Segment sofort allen anderen Mitgliedern der Arbeitsgruppe zur Verfügung. Dadurch werden störende Unstimmigkeiten vermieden, etwa wenn dieselbe Schaltfläche einer Anwendung auf verschiedenen Bildschirmen unterschiedlich benannt wird. Sämtliche Übersetzungsschwierigkeiten, die mit der Koordination eines großen, verteilten Teams einhergehen, werden durch integrierte Werkzeuge zur Qualitätssicherung und Terminologiekontrolle zuverlässig gelöst.
Vorteile für den Übersetzer: Tempo und kreativer Fokus
Häufig befürchten Berufseinsteiger, dass Automatisierungssysteme ihre Qualifikation entwerten. In der Praxis erlebt ein erfahrener Übersetzer die Datenbank vielmehr als unverzichtbaren digitalen Assistenten.
Die Technologie befreit den Menschen von ermüdender mechanischer Routine. Es ist nicht mehr erforderlich, lange rechtliche Hinweise, Kundendienstadressen, Standardklauseln oder sich wiederholende Spezifikationstabellen manuell einzugeben. Das komfortable Arbeitstempo des Übersetzers verdoppelt oder verdreifacht sich auf vier- bis fünftausend Wörter pro Arbeitstag. Die freigesetzten geistigen Kapazitäten können gezielt für anspruchsvolle kreative Aufgaben genutzt werden: die Adaption komplexer Metaphern, den Feinschliff zugkräftiger Werbetexte und das gründliche stilistische Lektorat zentraler Textabschnitte.
Wem die Datenbank gehört und wie sie gepflegt werden muss
Eine grundlegende Frage, die jeder weitsichtige Auftraggeber beachten muss, betrifft die Eigentumsrechte an den aufgebauten Sprachdaten. Das Translation Memory ist ein strategischer Vermögenswert des Kunden, der aus dessen Unternehmensbudget bezahlt wurde. Nach Projektabschluss sollte die Datenbankdatei im international standardisierten TMX-Format zusammen mit den fertigen Texten an den Kunden übergeben werden.
Gleichzeitig muss die Datenbank fachgerecht gepflegt werden. Im Laufe der Zeit ändern sich Unternehmensrichtlinien, Werbeslogans werden erneuert oder technische Standards veralten. Findet keine regelmäßige Überprüfung statt, bei der veraltete Segmente gelöscht werden, schlägt das System bei neuen Veröffentlichungen weiterhin unpassende Formulierungen vor. Regelmäßige Bereinigungen und eine sorgfältige Glossarpflege sichern dauerhaft hohe Qualität über viele Jahre hinweg und erleichtern das Meistern typischer Übersetzungshürden bei der Unternehmensskalierung.
Praktische Empfehlungen für erfolgreiche Projekte
Die Translation-Memory-Technologie hat sich längst von einer Innovation zu einem verbindlichen Qualitätsstandard im Sprachendienstleistungssektor gewandelt. Wenn Ihr Unternehmen regelmäßig Unternehmensunterlagen übersetzt, Kataloge aktualisiert oder eine mehrsprachige Website betreibt, sollte der Aufbau einer eigenen Übersetzungsdatenbank oberste Priorität haben.
Auftraggeber sollten von ihren Dienstleistern von vornherein den Einsatz professioneller Systeme und transparente Analyseberichte einfordern sowie ihre TMX-Dateien sorgfältig aufbewahren und weiterentwickeln. Für Fachübersetzer ist die Beherrschung moderner Werkzeuge unverzichtbar, denn erst das Zusammenspiel aus qualifizierten Fachkräften und zeitgemäßer Technologie garantiert erstklassige professionelle Übersetzungen. Der gezielte Einsatz eines Translation Memory schützt Unternehmen vor unnötigen Ausgaben, bürgt für terminologische Präzision und ebnet den direktesten Weg für eine erfolgreiche internationale Expansion.