Oversettelsesminne (Translation Memory): hvordan det sparer tid og penger
Forestill deg situasjonen: et stort industriselskap utgir den årlige oppdateringen av brukermanualen for komplekst industrielt utstyr på tre hundre sider. Endringene berørte bare noen få tekniske enheter, ikke mer enn fem prosent av kildeteksten ble skrevet om, men en uerfaren prosjektleder sender dokumentet til et byrå og mottar en faktura på full pris for å oversette alle tre hundre sider fra bunnen av. Å betale to, tre eller til og med ti ganger for å oversette de samme setningene er en av de vanligste og mest ergrelige økonomiske feilene i bedriftssektoren. Å unngå slike uberettigede utgifter muliggjøres av teknologien Translation Memory, som fundamentalt har endret økonomien i internasjonal lokalisering og etablert transparente samspillsregler mellom næringslivet og leverandørene. I denne artikkelen går vi grundig gjennom hvordan et oversettelsesminne er bygget opp, hvilke prinsipper oppdragsgiverens reelle gevinst beregnes etter, og hvorfor denne databasen blir den fremste strategiske digitale ressursen for ethvert globalt varemerke.
Hva en Translation Memory-database er og hvordan den skiller seg fra nevrale nettverk
Blant oppdragsgivere av språktjenester råder det fortsatt ofte forvirring mellom begrepet Translation Memory og maskinoversettelsesalgoritmer. Det er viktig å understreke den prinsipielle forskjellen: et oversettelsesminne har ingenting med kunstig intelligens, generative nettverk eller algoritmers sannsynlighetsberegninger å gjøre. Det er en dynamisk, kontinuerlig oppdatert database som utelukkende består av setningspar som tidligere er oversatt av et menneske og kvalitetssikret av en kvalifisert redaktør.
Hver oppføring i en slik database kalles en oversettelsesenhet eller et segment. Strukturelt forener den kildesetningen og dens nøyaktige ekvivalent på målspråket. Når en lingvist åpner en ny fil i et spesialisert dataassistert oversettelsesverktøy, analyserer systemet umiddelbart hele teksten og sammenholder hver setning med den opparbeidede prosjekthistorikken. Hvis frasen allerede har forekommet tidligere, setter programmet straks inn det ferdige alternativet. Mens maskinoversettelse genererer tekst på nytt basert på statistiske mönster eller nevrale vekter, henter et oversettelsesminne en utprøvd, samordnet og menneskegodkjent løsning. Takket være dette bevarer profesjonell oversettelse hundre prosent pålitelighet og feilfritt meningssamsvar.
Sammenstillingsmekanikken: fra eksakte treff til fuzzy-søk
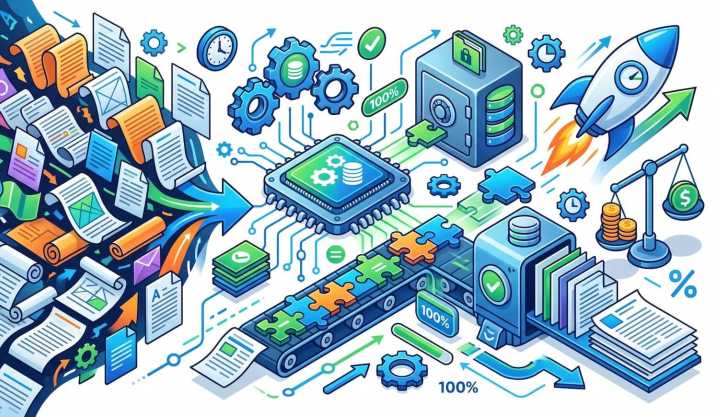
Styrken til Translation Memory-teknologien ligger i et matematisk nøyaktig system for klassifisering av treff. Programvaren deler hele volumet av den analyserte teksten inn i flere kategorier som avgjør fagpersonens reelle arbeidsinnsats.
Den første kategorien er hundreprosents treff, der en ny setning bokstav for bokstav gjentar et segment fra databasen. Et enda sikrere alternativ regnes som kontekstuelt treff, ofte betegnet som 101 prosent eller In-Context Exact Match. I dette tilfellet stemmer ikke bare selve setningen, men også den foregående og etterfølgende frasen, noe som helt utelukker risikoen for meningsfeil på grunn av endret kontekst eller spesifikk ombrekking.
Den neste kategorien kalles delvise treff, eller Fuzzy Matches. Systemet beregner graden av likhet mellom den nye setningen og den som finnes i databasen i et intervall fra syttifem til nittini prosent. Hvis det for eksempel i en ny instruksjon bare er apparatmodellen eller et enkelt parameter-tall som er endret, viser programmet den gamle varianten til fagpersonen og markerer tydelig fragmentet som krever punktvis redigering. Til slutt registreres interne gjentakelser i selve dokumentet på en egen linje. Hvis et slagord, en tabelloverskrift eller en advarsel gjentas femti ganger i håndboken, oversetter lingvisten det bare én gang, og systemet overfører automatisk løsningen gjennom hele filen.
Reell budsjettbesparelse: hvordan rabattskalaen fungerer
Forekomsten av en tydelig gradering av treff har skapt en allment anerkjent standard for oppgjør i den globale bransjen, kjent som CAT-grid eller prosjektets analysematrise. Før det faktiske arbeidet starter, skanner programvaren de overleverte filene og utarbeider en detaljert rapport med nøyaktig fordeling av ordene på de ulike kategoriene.
På grunnlag av denne rapporten betaler ikke oppdragsgiveren for prosjektet etter en enhetlig grunnsats, men etter en differensiert skala. For helt nye segmenter, som ikke har noen motpart i databasen, faktureres full arbeidskostnad. For delvise treff med høy likhetsgrad betaler kunden bare tretti eller femti prosent av grunntaksten, ettersom det er tilstrekkelig for oversetteren å redigere noen få tegn raskt. For hundreprosents og kontekstuelle treff samt interne repetisjoner er satsen minimal, eller det tas overhodet ikke betalt dersom prosjektet ikke krever en ny ekspertgjennomgang.
I store prosjekter for lokalisering av teknisk dokumentasjon, standardiserte juridiske kontrakter eller brukergrensesnitt for programvare gjør innføringen av denne teknologien det mulig for bedrifter å spare mellom tretti og seksti prosent av det samlede budsjettet på permanent basis.
Terminologisk enhet og samstemt teamarbeid
I tillegg til den direkte økonomiske gevinsten løser et oversettelsesminne den kritiske oppgaven med å sikre terminologisk enhet. I store konsern kan titalls spesialister fra ulike land arbeide samtidig med lokaliseringen av ett og samme produkt. Skybaserte plattformer som Trados, memoQ, Smartcat eller Phrase lar lingvister koble seg til en felles sentralisert database i sanntid.
Så snart én fagperson oversetter og godkjenner en krevende komponentbetegnelse eller en grensesnittfunksjon, blir dette segmentet umiddelbart tilgjengelig for alle andre deltakere i arbeidsgruppen. Som et resultat unngås kjedelige avvik, som at samme knapp i en applikasjon kalles ulike ting på tilstøtende skjermbilder. Alle oversettelsesutfordringer knyttet til koordinering av et stort, distribuert team nøytraliseres effektivt gjennom innebygde verktøy for kvalitetssikring og terminologikontroll.
Fordeler for lingvisten: tempo og kreativt fokus
Det er ikke sjelden at ferske oversettere frykter at automatiseringssystemer devaluerer kompetansen deres. I praksis opplever imidlertid en erfaren oversetter databasen med innsamlet materiale som en uunnværlig digital assistent.
Tekniken frigjør mennesket fra utmattende mekanisk rutinearbeid. Fagpersonen trenger ikke lenger å skrive av tunge ansvarsfraskrivelser, adresser til servicesentre, standard juridiske forbehold eller gjentakende tabeller med tekniske data manuelt. Tempoet i lingvistens komfortable arbeid øker med to eller tre ganger, og når fire eller fem tusen ord i løpet av en arbeidsdag. De frigjorte intellektuelle ressursene rettes i stedet mot å løse utradisjonelle kreative oppgaver: tilpasse komplekse metaforer, finslipe selgende overskrifter og foreta en grundig stilistisk gjennomgang av nøkkelavsnitt.
Hvem som eier databasen og regler for godt vedlikehold
Det viktigste spørsmålet som enhver framsynt oppdragsgiver må huske på, gjelder eiendomsretten til de innsamlede språkdataene. Et oversettelsesminne er oppdragsgiverens strategiske aktivum, betalt over virksomhetens eget budsjett. Når prosjektet er fullført, skal databasefilen i det internasjonalt anerkjente TMX-formatet overleveres til oppdragsgiveren sammen med den ferdige teksten.
Samtidig må databasen vedlikeholdes fagmessig. Med tiden endres bedriftens retningslinjer, markedsføringsslagord fornyes eller tekniske standarder blir foreldet. Hvis man ikke jevnlig gjennomfører revisjoner og sletter utdaterte segmenter fra databasen, vil systemet fortsette å beredvillig foreslå foreldede formuleringer i nye utgivelser. Regelmessig opprydding og vedlikehold av ordlister garanterer et stabilt høyt resultat over mange år, og gjør det enkelt å overvinne alle oversettelsesutfordringer når virksomheten skal skalere opp.
Praktiske konklusjoner for vellykkede prosjekter
Teknologien Translation Memory har for lengst beveget seg fra å være en innovasjon til å bli en obligatorisk standard for godt språkarbeid. Hvis bedriften din regelmessig oversetter virksomhetsdokumenter, oppdaterer kataloger eller videreutvikler et flerspråklig nettsted, bør opprettelsen av en egen oversettelsesdatabase være et prioritert første skritt.
Oppdragsgiverer bør fra første stund kreve at leverandører benytter automatiserte systemer og transparente rapporter i henhold til treffskalaen, samt ta godt vare på og videreutvikle sine TMX-filer. For fagoversettere er det avgjørende å mestre profesjonelle verktøy, for det er nettopp en kvalifisert oversetter i tospann med avansert teknologi som utgjør moderne profesjonell oversettelse i toppklassen. Fornuftig bruk av oversettelsesminnet beskytter virksomheten pålitelig mot unødige kostnader, sikrer upåklagelig terminologisk presisjon og åpner den raskeste veien til vellykket internasjonal ekspansjon.